Contenido
Hay un momento muy concreto en la vida de un proyecto en el que te das cuenta de que algo va mal. No porque se caiga, ni porque dé errores a lo loco. No. Te das cuenta porque dices en voz alta: “hay que tocar este módulo” y, de repente, todo el mundo mira para otro lado. Nadie te mira a los ojos. Uno se levanta “a por café”. Otro dice que justo tenía que irse al médico. Y el junior desaparece misteriosamente del Slack.
Tu sistema funciona… pero nadie quiere meterle mano.
Eso, amigo mío, es la señal más clara de que tu diseño apesta.
Hoy vamos a hablar de por qué pasa eso. De esos “olores” de mantenibilidad que hacen que cualquier dev con instinto de supervivencia huya. De qué aspecto tienen por dentro esos sistemas, de qué historias hay detrás, y de cómo acabaste ahí sin darte cuenta. Y sí, habrá humor, porque si no, acabas llorando.
Ese tufillo raro: qué es un “code smell” de verdad
Vamos a empezar poniendo nombre al monstruo, pero sin ponernos rancios.
“Code smell” no es otra cosa que esa sensación de “esto huele mal” cuando miras un trozo de código o una arquitectura. No necesariamente significa que haya un bug hoy. Significa que, tal y como está, mantener eso va a ser un sufrimiento, y que probablemente detrás hay una decisión de diseño discutible.
La palabra se la inventó Kent Beck a finales de los noventa, y Martin Fowler la hizo famosa en 1999 con un libro que se llama Refactoring. Si no les pones cara: Beck es el padre de Extreme Programming y del desarrollo guiado por pruebas tal y como lo conocemos; Fowler es probablemente el divulgador de arquitectura de software más leído del mundo. Los dos firmaron el Manifiesto Ágil. Vamos, que no son dos tíos opinando en un foro.
En ese libro hay un capítulo escrito a cuatro manos que es básicamente un catálogo de malos olores: cada uno con su nombre, cómo reconocerlo y qué refactorización aplicar para quitarlo. Medio sector aprendió a hablar de código mal diseñado con ese vocabulario. Y la idea central es esta: los code smells son síntomas, no diagnósticos definitivos. Igual que cuando entras en una habitación y notas humedad. No ves la gotera todavía, pero sabes que algo no está bien en el techo.
En todas las revisiones sobre code smells se repiten los sospechosos habituales: métodos gigantes que lo hacen todo, clases dios que saben de todo, dependencias cruzadas que convierten el código en espaguetis, lógica interesada en datos de otra clase más que en los suyos, configuraciones desperdigadas en diez sitios… y, en general, cualquier cosa que haga que cada cambio sea una aventura de riesgo laboral.
Así que vamos a bajar al barro con ejemplos que cualquier dev ha visto, sufrido y posiblemente producido. Si llevas un tiempo en el oficio, ya sabes de qué hablo.
El método Frankenstein: cuando una función lo hace todo
Seguro que has tenido que enfrentarte alguna vez “al método”. Ese. El que abre el fichero, hace las validaciones, calcula impuestos, manda emails, actualiza tres tablas, escribe en el log, y, si te descuidas, apaga las luces de la oficina.
El famoso “long method” es uno de los olores más viejos y más estudiados. Un estudio de 2018 sobre treinta proyectos open source encontró que los olores de código largo y complejo están entre los más extendidos, y que las clases que los tienen cambian más y acumulan más fallos que las limpias.
La explicación es sencilla: si un método de cientos de líneas hace de todo, nadie entiende el conjunto. Es más difícil ver qué parte afecta a qué. Cada vez que tocas algo, el alcance del fallo, como dicen algunos, se dispara: cambias una condición, rompes un caso que no sabías ni que existía.
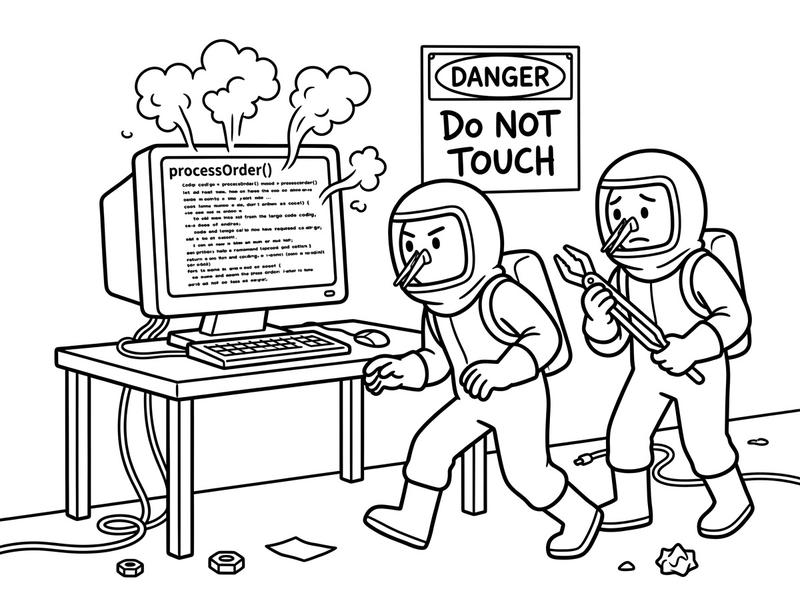
Imagina un controlador de pedidos de una tienda online. En teoría, debería orquestar cuatro cosas: validar, calcular, guardar, notificar. En la práctica, te encuentras un método processOrder() de 400 líneas. Dentro hay lógica de descuentos, lógica de fidelización, una consulta directa a la base de datos porque “era más rápido hacerlo ahí”, y un par de if con comentarios tipo // TODO arreglar esto bien.
¿Consecuencia? Cada vez que marketing decide cambiar una regla de descuento, nadie quiere tocar processOrder(). Si el método falla, afecta al 80 % de los casos de uso. Si metes tests, cubrirlo todo es un infierno. Si quieres extraer algo, no sabes por dónde empezar.
Todos los artículos y presentaciones sobre “long methods” dicen siempre lo mismo: son difíciles de entender, de testear y de reutilizar; y suelen combinar múltiples niveles de abstracción, mezclando detalles de bajo nivel con decisiones de alto nivel. Es decir: son perfectas máquinas de agotar a quien las toca.
La razón por la que acaban así es bastante humana: las prisas. Empiezas con un método pequeño, añades dos casos especiales, luego otro, luego un if rápido “solo por ahora”, y cuando quieres darte cuenta tienes una novela dentro de una función. Y nadie se atreve a ser el primero que la destroza.
La Clase Dios: cuando tu diseño inventa su propio Vaticano
Subamos un nivel. Si el método Frankenstein es un clásico, la “God Class” (la clase dios) es directamente un meme académico.
Una God Class es esa clase que parece tener opinión sobre todo lo que pasa en tu aplicación: conoce todos los modelos, sabe todos los estados, tiene mil atributos, mil métodos, media base de código depende de ella, y si la tocas, se oye un grito a lo lejos en producción.
El concepto no es nuevo: Arthur Riel ya hablaba del “problema de la God Class” en Object-Oriented Design Heuristics, un libro de 1996. Y desde entonces muchos estudios sobre code smells la sitúan entre los peores olores: centraliza demasiado control y estado, se convierte en un cuello de botella para la evolución del sistema (cualquier cambio, venga de donde venga, acaba pasando por ella) y suele concentrar tanto cambio que acaba llena de bugs. Hay incluso gists y guías con consejos tipo: “si tu clase tiene varios miles de líneas, es un olor enorme; empieza a extraer dependencias a nuevas clases y llévate el código con ellas”.
Piensa en el típico ApplicationService o Manager universal: el UserManager que crea usuarios, borra usuarios, envía emails, gestiona permisos, restablece contraseñas, gestiona el inicio de sesión con redes sociales, gestiona tokens, escribe logs y prepara el desayuno. O el mítico OrderService, que se encarga de todo lo relacionado con pedidos, pagos, devoluciones, inventario, logística y el clima de Marte.
¿Quién quiere mantener eso? Nadie en su sano juicio.
Técnicamente, lo que hace una God Class es saltarse a lo bestia el principio de responsabilidad única. Es la S de SOLID, el acrónimo que popularizó Robert C. Martin, el famoso “Uncle Bob”, y que sale en todas las entrevistas técnicas. La formulación es muy sencilla: una clase debería tener una sola razón para cambiar.
Piensa en el UserManager de antes. Cambia si marketing quiere otro email de bienvenida. Cambia si seguridad endurece la política de contraseñas. Cambia si el proveedor de inicio de sesión toca su API. Cambia si alguien quiere otro formato de log. Cuatro equipos, cuatro motivos, una sola clase. Y cada cambio de uno puede romper lo de los otros tres. Por eso la receta es siempre la misma: partirla en clases más pequeñas, cada una con un único motivo para cambiar. No es una cuestión estética: es que así dejas de tener cuatro equipos pisándose en el mismo fichero.
Estas clases suelen aparecer por falta de planificación y por una arquitectura pobre, y es muy habitual que un sistema tenga “dos dioses”: la clase usuario y la clase que concentra el foco del negocio.
La causa más habitual es esa obsesión por “centralizar” porque “así está todo en un sitio”. Empiezas moviendo lógica desde otras capas a una clase común “para no duplicar”. Poco a poco, todo lo que no sabes dónde poner acaba ahí. Y, al final, tienes una deidad caprichosa que manda sobre todo y rompe todo.
Y claro, nadie quiere ser el hereje que toca la clase dios. Demasiado riesgo por poca gloria.
Dependencias enredadas: el espagueti de microservicios y librerías
Pasemos al plano arquitectónico. Hay una señal clarísima de que tu diseño apesta: cuando el diagrama de dependencias parece una telaraña tejida por una araña borracha.
En código monolítico, esto se manifiesta en forma de dependencias cíclicas entre módulos o librerías: módulo A depende de B, B depende de C, y C depende de A. O incluso cosas más delirantes, como librerías que se importan mutuamente. Un ejemplo muy simple que se cita en artículos sobre code smells: la librería X depende de la librería Y, y la Y depende de la X. Eso complica la compilación, el despliegue y las pruebas, y hace prácticamente imposible reutilizar nada por separado.
En el mundo de los microservicios, el espagueti es aún más divertido. Sobre el papel, cada servicio va a ser independiente, pequeñito, con límites claros. En la práctica, sin un diseño de dominios decente, acabas con servicios que se llaman unos a otros en bucles, flujos de negocio que cruzan diez servicios para hacer algo que antes hacía un monolito en tres llamadas a la base de datos, y latencias que dan risa.
Y hay una variante de este olor que no viene de tu código, sino del de los demás. La gente que se dedica a la seguridad en microservicios habla de “tangled dependency trees”: árboles de dependencias enmarañados, con cientos de librerías de terceros mezcladas con tus propios servicios, donde una vulnerabilidad en una sola dependencia puede afectar a todo el sistema. El ejemplo de libro es Log4Shell. En diciembre de 2021 apareció una vulnerabilidad en Log4j, una librería de Java para escribir logs que usa medio planeta: bastaba con que tu aplicación registrase en el log un texto preparado por el atacante (por ejemplo, un nombre de usuario) para que este pudiera ejecutar código en tu servidor.
Pero lo interesante para nosotros no fue el parche, sino lo que vino antes del parche: muchas empresas tardaron días, o semanas, en averiguar dónde la tenían. No la habían importado ellas; venía escondida en una dependencia de una dependencia. Es el mismo problema que el de tus microservicios, a otra escala: no sabes de qué dependes hasta que se rompe.
Otros, desde la arquitectura, cuentan historias de sistemas donde se habían montado microservicios sin disciplina. Resultado: una red compleja de llamadas entre servicios, con dependencias no documentadas, donde cada nuevo servicio añadía una arista más al grafo hasta que nadie podía dibujar el conjunto sin llorar. La solución que suelen proponer es la típica: mapear toda la arquitectura con herramientas de trazado distribuido, agrupar servicios por dominios y cortar dependencias innecesarias.
Detrás de todos estos casos está lo mismo: ausencia de límites claros. Dominios mal definidos, conveniencia a corto plazo, “tiro una llamadita a este servicio, total, qué más da”. Y, al final, un sistema donde cualquier cambio pequeño puede tener consecuencias inesperadas en sitios que ni sabías que estaban conectados.
¿Resultado práctico? Nada se puede cambiar sin miedo. Y, por tanto, nadie quiere mantenerlo.
Configuración por todas partes: el festival del sprawl
Otro olor fino, de esos que no ves hasta que te explota, es el de la configuración esparcida.
Empieza de forma inocente.
Tienes un config.yml.
Bien.
Luego añades una variable de entorno “rápida” para no tocar el fichero. Luego metes una tabla de configuración en la base de datos. Luego otro equipo añade flags en un panel interno. Y cuando quieres darte cuenta, cambias un valor en un sitio y el sistema sigue comportándose como antes porque ese valor se sobrescribe desde otro sitio que nadie recuerda.
En el mundo de la infraestructura y la nube, esto se llama directamente “configuration sprawl”: configuración que se dispersa por mil sitios, cambiada por equipos distintos, sin una visión central, hasta que aparecen fallos de seguridad, caídas o sustos de auditoría. Lo de “sprawl” viene del urbanismo: el “urban sprawl” es cuando una ciudad crece a lo loco hacia fuera, urbanización tras urbanización, sin plan y sin centro.
Y esto no es solo incómodo; es peligroso. Cuando la configuración vive en mil sitios, nadie la revisa entera, y ahí es donde se cuelan los valores que no deberían estar. Varios análisis recientes sobre errores de configuración en la nube dicen que son de las causas más comunes de brechas de datos y caídas: almacenamiento expuesto, permisos demasiado generosos, ajustes por defecto inseguros, y nadie enterándose porque “todo parecía funcionar”. Gartner llegó a predecir en 2019 que hasta 2025 el 99 % de los fallos de seguridad en la nube serían culpa del cliente, no del proveedor. Y casi siempre, por configuración.
En la configuración de aplicaciones pasa lo mismo. Si tus timeouts están en cuatro sitios distintos, si los endpoints dependen de tres capas de valores que se pisan unos a otros, si tienes flags que se activan con combinaciones raras de valores en la base de datos, nadie sabe qué configuración está realmente activa en producción. Cualquier cambio se convierte en un acto de fe.
Otra variante moderna es el “secret sprawl”: secretos (tokens, claves, contraseñas) repartidos por mil repositorios, servicios, pipelines, hasta que es imposible localizarlos todos. Hay voces que ya avisan: cuando los secretos se dispersan así, ya no es solo un problema de seguridad, es un problema de continuidad de negocio. Si no sabes dónde están tus propios secretos, tampoco sabes qué se rompe cuando caducan, se revocan o cambias de proveedor.
¿Y qué tiene que ver esto con la mantenibilidad? Todo.
Si nadie entiende de dónde salen los valores que gobiernan tu sistema, cambiar su comportamiento es un infierno. Resolver incidentes se vuelve una gincana. Y el típico “funcionaba en staging pero no en producción” deja de ser un chiste para convertirse en tu día a día.
El config sprawl es el equivalente organizativo a ese cajón de cables en casa: sabes que tienes un cable HDMI por ahí, pero prefieres ir a comprar uno nuevo antes que meter la mano. Pues lo mismo con tu sistema: nadie quiere ser quien toque la configuración global.
Demasiados conceptos: cuando tu modelo de dominio es un museo
Menos comentado pero igual de sufrido: el olor de los “demasiados conceptos”.
Te lo encuentras cuando entras en una base de código y descubres que, para representar algo simple, hay cinco tipos distintos. Por ejemplo, algo tan inocente como “cliente”: tienes Customer, Client, User, Account, Profile… todos con campos parecidos, relaciones parecidas, usos parecidos, pero no iguales. Algunos se usan en facturación, otros en marketing, otros en autenticación. Y ninguno coincide del todo con los demás.
En revisiones académicas sobre code smells a esto se le llama “modelos redundantes”: varias clases que representan lo mismo y que complican entender el dominio. Y suele venir con un primo pequeño, los “data clumps”: grupos de datos que siempre viajan juntos pero que nadie ha metido en una clase. Calle, número, ciudad y código postal pasando como cuatro parámetros sueltos por veinte métodos, en vez de vivir en una clase Direccion. Cuando tienes cinco clientes, apuesta lo que quieras a que la dirección anda desperdigada así en tres de ellos.
Pero más allá de la teoría, el efecto es muy humano: cualquier dev nuevo se pierde. No sabe qué clase usar. No sabe dónde añadir un campo. No sabe si cambiar un atributo en un sitio va a dejar otro objeto desfasado en otra parte.
De nuevo, la razón es bastante simple: falta de disciplina conceptual. Cada equipo, cada dev, cada sprint añade sus conceptos sin limpiar los anteriores. Nadie se para a decir “este concepto ya lo teníamos, usemos el mismo”. Se improvisa. Y al final el dominio se convierte en un museo de esculturas medio repetidas.
Ojo, que aquí hay trampa. La solución no es fundir los cinco en un único Cliente gigante con todos los campos del mundo, porque eso es fabricarte otra clase dios. Eric Evans, en Domain-Driven Design, el libro de 2003 que puso de moda hablar de dominios, defiende justo lo contrario: que facturación y autenticación tengan cada una su propia idea de cliente puede ser perfectamente legítimo, siempre que esté claro dónde empieza y dónde acaba cada una. Él lo llama contextos delimitados (bounded contexts). Lo que apesta no es que haya varios modelos. Es que nadie sepa por qué existen, ni cuál manda en cada sitio.
¿Quién quiere mantener eso? Nadie. Porque cada decisión requiere estudiar media docena de tipos antes de saber dónde meter mano.
El sistema que nadie entiende: cuando hasta la IA se rinde
Vamos a juntar todos estos olores en una escena.
Un equipo decide ir rápido y adopta código generado por herramientas de IA para montar gran parte de la aplicación. Durante seis meses, las máquinas vomitan clases, servicios, helpers y configuraciones a una velocidad que hace que todo parezca avanzar mucho.
El problema llega cuando alguien quiere añadir una funcionalidad relativamente sencilla. Y lo cuenta en un artículo: le llevó tres días algo que, en teoría, habría sido trabajo de medio día. ¿Por qué? Porque el código que tenía delante era una maraña de funciones largas, clases grandes, duplicaciones, modelos redundantes y acoplamientos ocultos. No había “visión global”. Ni la persona, ni la herramienta que lo había generado, ni nadie tenía una idea clara de cómo encajaba todo.
El autor lo describe así: entrar en esa base de código era sentir todo el catálogo de code smells golpeándote a la vez. Long methods, god classes, data clumps, feature envy, duplicated logic… la colección completa. Cada cambio requería excavar en capas de decisiones automáticas no revisadas.
Esta historia es interesante porque nos rompe una ilusión moderna: no, el problema no es solo que el humano escriba mal. Si no diseñas límites, si no controlas los conceptos y la arquitectura, puedes producir malos olores igual de bien con IA que con un teclado y café. Las herramientas potencian, no sustituyen, tu disciplina o tu dejadez.
Y desde el punto de vista de la mantenibilidad, el resultado es el mismo: nadie quiere meterse ahí. Ni humanos ni agentes de IA. Es un sistema que literalmente se ha vuelto hostil a la intervención.
Lo que le pasa a tu equipo cuando el diseño apesta
Hasta ahora hemos hablado de código y arquitectura. Vamos un momento a las personas, que son las que acaban refugiándose en “no, eso mejor que lo toque otro”.
Cuando un sistema acumula todos estos olores, ocurre una cosa muy concreta: la gente deja de confiar en su capacidad de cambiarlo sin romperlo. Cada refactorización es una ruleta rusa. Cada funcionalidad nueva se alarga porque antes tienes que entender medio sistema para cambiar dos líneas.
En la literatura sobre mantenimiento se insiste mucho en que los code smells son indicadores de problemas estructurales que dificultan la evolución: a más smells, más defectos, más tiempo de cambio, más frustración. Y cuando varios olores conviven en la misma clase (por ejemplo, una God Class con otros olores encima), la cosa empeora: en un estudio en el que catorce desarrolladores eliminaron sesenta de estas combinaciones, lo que más les costaba no era la técnica de refactorización, sino entender el código.
Lo notas en cosas muy humanas:
El senior que siempre se apunta a proyectos nuevos pero esquiva como puede el sistema viejo. El junior al que le asignan “arreglar un par de cosas” en la clase dios y acaba teniendo pesadillas con ella. El de sistemas que sabe que la configuración es un caos y prefiere no tocar nada salvo que haya un incendio.
Se genera una cultura de miedo técnico: no se hacen cambios grandes, se acumulan parches, se aplazan decisiones importantes porque “igual rompemos algo”. Y cada aplazamiento añade otra capa de olor.
De repente, resulta que el problema no es que la gente sea vaga o caprichosa. Es que tu sistema es, objetivamente, hostil al mantenimiento. Y la gente se protege.
No es que odien tu sistema, es que les estás pidiendo que entren en una casa en ruinas
La imagen final que te quiero dejar es muy visual.
Tu sistema no es un templo de arquitectura perfecta que la gente desprecia por capricho. En muchos casos, es más bien una casa vieja donde, cada vez que levantas una baldosa, sale un cable que nadie sabe adónde va. Algunas paredes están apuntaladas con madera. Hay habitaciones selladas “porque ahí no entra nadie desde 2012”. Y de vez en cuando se oye un ruido en las tuberías.
Luego te extraña que nadie quiera mudarse ahí. Que todos prefieran trabajar en la obra nueva que acaban de empezar a dos calles.
Las señales claras de que tu diseño apesta – métodos gigantes, clases dios, dependencias cíclicas, configuración esparcida, demasiados conceptos duplicados – no son solo problemas “de elegancia”. Son razones prácticas por las que la gente prefiere no tocar tu sistema.
La línea entre un sistema con carácter y un sistema inmantenible es bastante fina.
Y sí, se puede trabajar para cruzarla en el sentido contrario: refactorizar, cortar dependencias, unificar modelos, centralizar la configuración de forma sensata. Y no hace falta inventarse nada: hay libros enteros sobre esto. Si tienes que empezar por uno, empieza por donde empezó todo: el Refactoring de Fowler. Además de ponerle nombre a cada olor, te explica cómo quitarlo paso a paso, en cambios pequeños y sin romper nada por el camino.
Y si tu casa en ruinas no tiene tests, que es lo más habitual, el libro es Working Effectively with Legacy Code, de Michael Feathers. Feathers define el código legacy de una forma que duele: código sin tests. Da igual que lo escribieras la semana pasada.
Y aquí está la conexión con el miedo del que hablábamos antes. La gente no evita tocar el código por cobardía; lo evita porque no hay red. Sin tests que te avisen de lo que has roto, cada cambio es un salto al vacío. La propuesta de Feathers es empezar justo por ahí: escribir tests que fijen lo que el sistema hace hoy, aunque lo haga mal, y solo entonces ponerse a trocear. Con red, la gente salta.
Pero el primer paso es aceptar lo obvio: si cada vez que dices “hay que tocar este módulo” la gente desaparece… igual el problema no es la actitud del equipo.
Igual el problema es tu diseño.
Y la próxima vez que te veas tentado de meter “solo un if más” en el método Frankenstein, o de colar “una lógica más” en la clase dios, piensa en tu yo del futuro, mirando el código y pensando: “¿quién fue el animal que hizo esto?”
Y date cuenta de que estás a punto de contestarte a ti mismo.
Glosario rápido
El diccionario que nadie escribió porque todos dieron por hecho que ya lo sabías.
- Code smell: señal en el código que indica un posible problema de diseño. No es un bug en sí, sino un síntoma de que algo podría complicar el mantenimiento.
- Feature envy: ocurre cuando una función accede constantemente a datos de otra clase en lugar de a los suyos propios. Señal de que esa lógica debería vivir en la otra clase.
- Data clumps: grupos de datos que siempre aparecen juntos en distintos lugares del código (parámetros, atributos) y que podrían encapsularse en un solo objeto o clase.
- Principio de responsabilidad única: la S de SOLID. Una clase debería tener una sola razón para cambiar.
- Contextos delimitados (bounded contexts): en Domain-Driven Design, fronteras explícitas dentro de las cuales un modelo (por ejemplo, “cliente”) tiene un significado concreto. Dos contextos pueden tener modelos distintos del mismo concepto sin que eso sea un olor.
- Código legacy: según Michael Feathers, código sin tests, independientemente de su edad.
- Blast radius (alcance del fallo): cuántas cosas se rompen cuando tocas una pieza. A mayor alcance, peor el aislamiento del diseño.
Fuentes y referencias
El olor llega antes que el bug. Estas fuentes son el desodorante.
- Code Smell – Martin Fowler. Origen del término, acuñado por Kent Beck durante la escritura de Refactoring.
- Refactoring: Improving the Design of Existing Code – Martin Fowler (con Kent Beck). El libro que popularizó el catálogo de code smells y cómo eliminarlos.
- Working Effectively with Legacy Code – Michael Feathers (2004). Estrategias para poner bajo tests y refactorizar código legacy.
- Domain-Driven Design – Eric Evans. Origen de los contextos delimitados y de la idea de modelar el dominio con fronteras claras.
- The Single Responsibility Principle – Robert C. Martin. Explicación del principio de responsabilidad única por su autor.
- CVE-2021-44228 (Log4Shell) – NIST National Vulnerability Database. Ficha oficial de la vulnerabilidad de Log4j.
- Is the Cloud Secure? – Gartner (2019). Predicción sobre el peso de los errores del cliente en los fallos de seguridad en la nube.
- Code Smells: Bad Code – Rently Engineering. Introducción práctica a los olores de código más comunes.
- Experiencia con una base de código generada por IA – Engineers Hub. Relato de primera mano sobre los smells acumulados en código generado automáticamente.
- Bad Code Smells – Lecture Slides – UFMG. Clasificación académica de los olores de diseño.
- Re-Engineering Slides – Scribd. Materiales sobre el impacto de los smells en el mantenimiento y la reingeniería.
- A Study on Code Smells – IJSR. Revisión académica sobre prevalencia y consecuencias de los code smells.
- Code Smell: Cyclomatic Complexity, Blast Radius y más – Dev.to. Artículo práctico sobre complejidad ciclomática, alcance del fallo y otros conceptos relacionados.
- On the diffuseness and the impact on maintainability of code smells – Fabio Palomba et al., Empirical Software Engineering (2018). Estudio a gran escala que relaciona los code smells con más cambios y más fallos.
- How do Code Smell Co-occurrences Removal Impact Internal Quality Attributes? – Júlio Martins, Carla Bezerra, Anderson Uchôa y Alessandro Garcia, SBES (2021). Estudio cualitativo sobre la eliminación de combinaciones de olores desde la perspectiva de los desarrolladores.
- God Class Refactoring Tips – GitHub Gist. Guía práctica para desmantelar God Classes.
- Microservices Security: From Fundamentals to Advanced Patterns – Dev.to. Incluye el caso Log4Shell como ejemplo de riesgo en árboles de dependencias enmarañados.
- You’re Struggling with Tangled Microservice Dependencies – LinkedIn Advice. Estrategias para desenredar dependencias en arquitecturas de microservicios.
- Detect Security Misconfigurations – PurpleLens. Análisis sobre misconfiguraciones en cloud como causa de brechas y caídas.
- When Does Secret Sprawl Become a Business Continuity Problem? – NHIMG. Por qué la dispersión de secretos es más que un problema de seguridad.
- Configuration Management – Avi Har-El. Artículo sobre gestión de configuración y sus riesgos.
- Re-Engineering Legacy Code (vídeo) – YouTube. Introducción visual a técnicas de reingeniería.
- Data Sprawl – Palo Alto Networks. Definición y consecuencias del sprawl de datos y secretos.
Otros idiomas: English